Warten Sie nicht auf das Scheitern: Vervielfachen Sie Bereitstellungsdaten durch Simulation
Von Szymon Trochimiak, leitender ML-Forschungsingenieur
Für die physikalische KI sind Simulation und reale Welt keine konkurrierenden, sondern komplementäre Datenquellen. Manchmal öffnet sich ein Gegenstand, während der Roboter ihn trägt. Erkennt der Roboter einen zerlegten Gegenstand, kann er anhalten und Hilfe anfordern. Genau das ist die Aufgabe der Live-Anomalieerkennung (LAD). Die Schwierigkeit besteht darin, diese Anomalien zu erkennen, da der Roboter ihnen selten begegnet (deshalb sind sie ja Anomalien). Im Folgenden beschreiben wir, wie wir mithilfe synthetischer Daten erfolgreich LAD Fehler beigebracht haben, die in der Produktion selten auftreten.
Was LAD tut
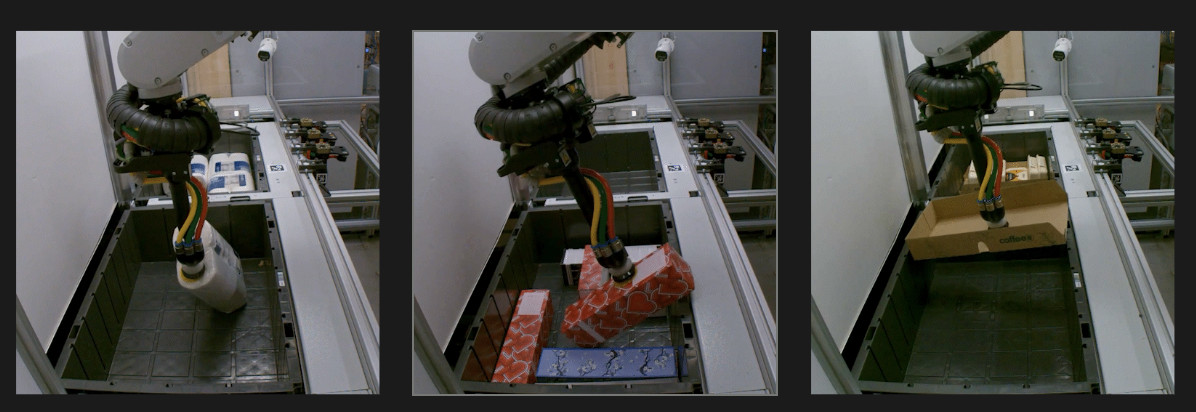
Die Live-Anomalieerkennung ist ein Bildverarbeitungssystem, das die Kamerabilder während jedes Kommissioniervorgangs mit 15 Bildern pro Sekunde überwacht. Für jedes Bild entscheidet es, ob eine Anomalie (z. B. ein zerlegtes Teil) vorliegt. Wenn das Modell bei einem Versuch in drei aufeinanderfolgenden Bildern eine Anomalie erkennt, pausiert der Roboter, und ein Bediener überprüft den Vorgang.
LAD wird anhand zweier Kennzahlen bewertet:
Falsch-Negativ-Rate (FNR) ist der Anteil der zerlegten Kartons, den wir nicht erkennen;
Falsch-Positiv-Rate (FPR) ist der Anteil guter Tipps, den es fälschlicherweise stoppt.
Ein Fehler kann dazu führen, dass Medikamente mit fehlendem Inhalt im Paket eines Kunden landen. Ein Fehlalarm kostet die Aufmerksamkeit des Bedieners und wertvolle Zykluszeit an einer Station, die für Hunderte von Kommissionierungen pro Stunde ausgelegt ist. Bei hohem Durchsatz summieren sich diese Sekunden, daher ist es unser Ziel, sowohl die Falsch-Positiv-Rate (FPR) als auch die Falsch-Negativ-Rate (FNR) zu minimieren.
Warum Daten die Schwierigkeit darstellen
Roboter zeichnen jeden Pickvorgang auf, daher gibt es reichlich Videomaterial. Nützliche Beschriftungen hingegen nicht. Vier Faktoren erschweren dieses Problem:
Positive Ergebnisse sind selten. Etwa 1%-Prävalenz. Unser erster zurückgehaltener Testdatensatz hatte 37 positive Versuche gegenüber 2.604 sauberen Versuchen. Bei so wenigen positiven Fällen erhöht eine zusätzliche Erkennung die Trefferquote um fast drei Prozentpunkte. Das macht es schwierig, Fortschritte zu messen und noch schwieriger, daraus zu lernen.
Etiketten sind teuer. Das Taggen des Boxstatus Bild für Bild ist langsam. Die meisten Produktionsvideos werden nie beschriftet, und keiner der Fälle, die wir am dringendsten benötigen – Boxen kurz vor dem Öffnen – ist leicht zu finden.
Das Labor sieht nicht wie eine Produktionsstätte aus. Wir haben in unserem Labor an vorbereiteten Teilen etwa 1.600 Demontagevorgänge nachgestellt. Laborzellen unterscheiden sich jedoch optisch deutlich von der Produktion. Daher führte die Hinzunahme von Labordaten nicht zu einer zuverlässigen Verbesserung der Produktionskennzahlen. Das Modell ließ sich nicht auf andere Umgebungen übertragen.
Die Klassengrenzen sind subtil. “Teilweise geöffnet” und “vollständig geöffnet” unterscheiden sich um wenige Grad Klappenwinkel. Die Kommentatoren sind sich uneinig darüber, wo genau das Modell ein klares Signal am dringendsten benötigt.
Warum wir rendern statt generieren
Die naheliegende “Abkürzung” wäre ein generatives Bildmodell, doch dieses versagt genau bei den Dingen, die wir benötigen. Die verbale Beschreibung, wo “teilweise geöffnet” endet und “vollständig geöffnet” beginnt, ist unzuverlässig. Es ist außerdem schwierig, die Dasselbe Ein Kasten mit 20 und 25 Grad Öffnungswinkel – ein kontrastierendes Paar, das eine Grenze aufzeigt. Eine anhand einer Vorgabe abgelesene Bezeichnung ist eine Vermutung. Eine aus der Geometrie abgeleitete Bezeichnung ist exakt.
Wir haben also in Blender einen parametrischen Faltschachtelkarton für Arzneimittel modelliert. Jede für das Etikett relevante Eigenschaft ist ein expliziter Parameter:
Öffnung von 0° (geschlossen) bis 180° (vollständig geöffnet), plus seitliche Spreizung und Einsteckklappen-Einrollung.
Inhaltsvorsprung – Entnahme von Blisterpackungen und Beipackzetteln, soweit die Öffnung dies physisch zulässt.
Oberflächenverschleiß – Wellen, Nähte, Falten und Rauheit.
Kunstwerk und Farbe, Kamerakalibrierungszittern und die fassen.
Wie gelangen wir von einer Spezifikation zu einer gerenderten und klassifizierten Box?
Die Spezifikation gibt für jeden Parameter eine Verteilung an.
Die Spezifikation wird in eine Szene pro Box aufgeteilt.
Die Szenen werden mit Blender Cycles auf GPUs gerendert.
Das Rendering wird in wiederaufnehmbare Abschnitte unterteilt, einen pro GPU. Jeder Rendervorgang dauert etwa 20 Sekunden.
Die Klasse ergibt sich dann aus der Geometrie:
Bei einem Öffnungswinkel von über 23,5° gilt die Box als vollständig geöffnet (und wird als zerlegter Artikel gewertet).;
Ein Winkel zwischen 2,5° und 23,5° gilt als teilweise geöffnet (gilt nicht als zerlegt).
Abb. 1: Dargestellte Kartons in den vier Zuständen der Verpackung, so wie sie von der Handgelenkkamera erfasst werden.
Wie aus einem Rendering ein Produktionsbild wird
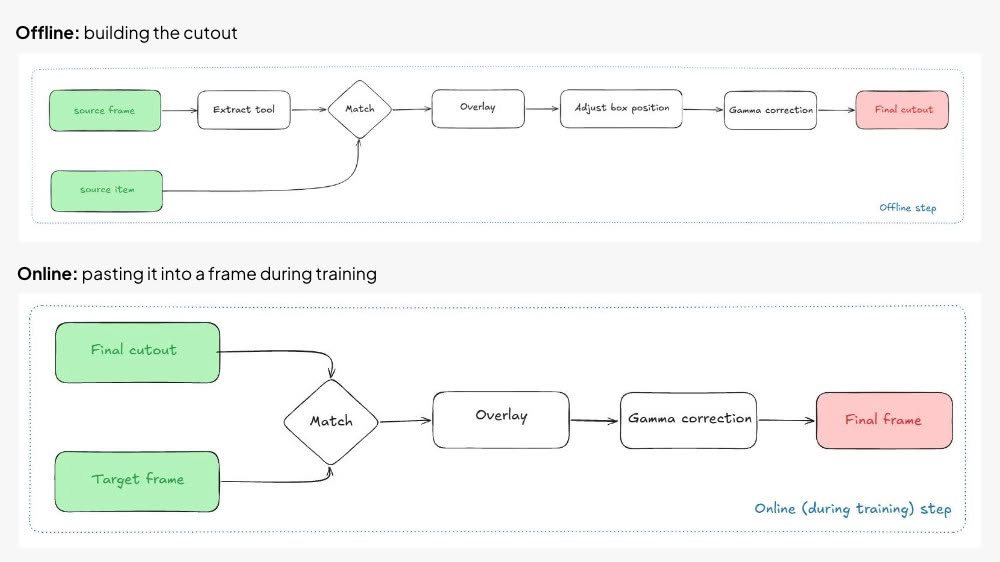
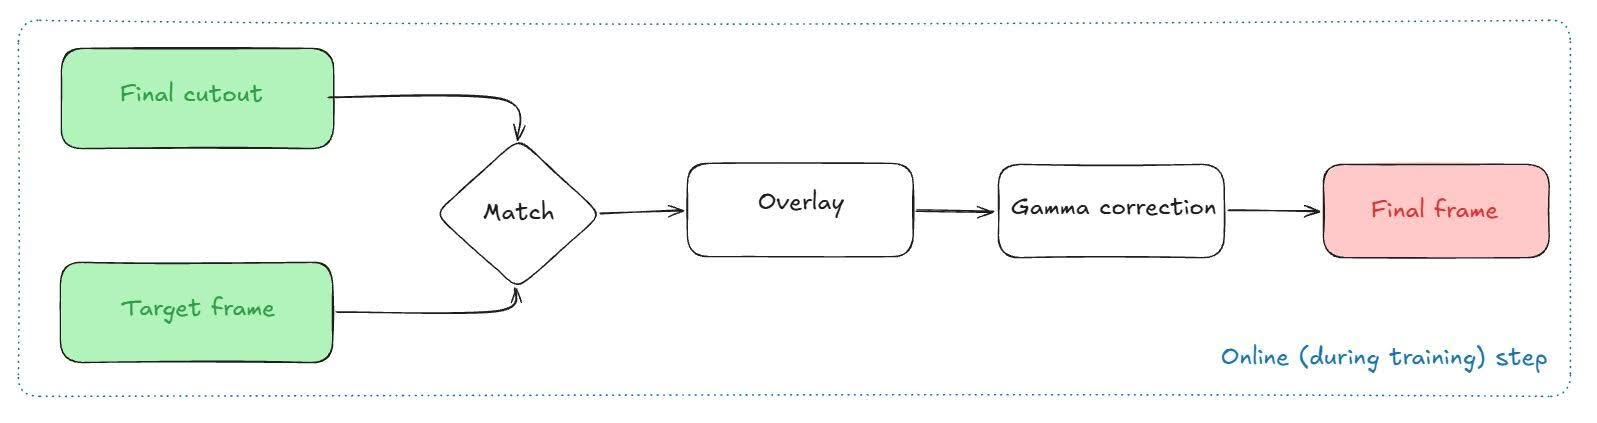
Ein gerenderter Karton auf grauem Hintergrund vermittelt einem Modell wenig über eine reale Produktionsumgebung. Daher integrieren wir ihn in realen Frames, und zwar in zwei Schritten. Im Offline-Schritt wird einmalig ein Ausschnitt – ein realer Greifer, der einen gerenderten Karton hält – erstellt und gespeichert. Im Online-Schritt wird dieser Ausschnitt bei jeder Trainingsdarstellung in einen realen Frame eingefügt, sodass derselbe Karton in vielen Szenen erscheint.
Offline: Bau des Ausschnitts
Abb. 2: Der Offline-Schritt, von einem Quellbild und einem gerenderten Element zu einem gespeicherten Ausschnitt.
1. Quellbild. Ein realer Rahmen aus der Produktion oder dem Labor, in dem der Roboter ein Objekt hält. Der Saugdruck zeigt an, ob der Greifer etwas hält, sodass diese Rahmen automatisch aufgenommen werden können.
2. Extrahieren Sie das Werkzeug. Unser internes Segmentierungsmodell erkennt den Greifer und das gehaltene Objekt. Wir behalten den Greifer bei und verwerfen alles andere, einschließlich des eigentlichen Objekts. Außerdem speichern wir die Helligkeit des Objekts und des gesamten Bildausschnitts für spätere Korrekturen.
3. Quellelement. Ein gerenderter Karton. Seine Klasse wird durch die Geometrie des Renderings festgelegt.
4. Anpassen und überlagern. Wir kombinieren den Greifer mit einem Rendering, das für dieselbe Kamera und dasselbe Werkzeug erstellt wurde, und legen den realen Greifer über den gerenderten Karton. Falls der Greifer den Karton nicht überlappt, verschieben wir den Karton, bis er es tut.
5. Gammakorrektur. Die Renderings sind hell und scharf. Wir passen die Helligkeit des Kartons an die Helligkeit des realen Gegenstands an, den er ersetzt, und speichern das Ergebnis als endgültigen Ausschnitt.
Online: während des Trainings in einen Rahmen einfügen.
Abb. 3: Der Online-Schritt, der während des Trainings ausgeführt wird und bei dem jedes Mal, wenn ein gespeicherter Ausschnitt gezeichnet wird, dieser in einen neuen Frame eingefügt wird.
7. Letzter Ausschnitt und Zielrahmen. Das Training lädt ein Ausschnittbild und ein reales Bild, in dem der Roboter nichts hält – beides vom selben Roboter, derselben Kamera und demselben Werkzeug. Wie die Quellbilder können auch diese durch ein Saugsignal erfasst werden.
8. Überlagerung und Gammakorrektur. Der Ausschnitt wird an seiner Position aufgeklebt. Die Handgelenkkamera ist fest mit dem Werkzeug verbunden, sodass der aufgeklebte Greifer den Greifer des Zielobjekts fast vollständig abdeckt und kein Inpainting erforderlich ist. Abschließend gleichen wir die Helligkeit des gesamten Quellbildes an die des gesamten Zielbildes an, wodurch das für das Training verwendete Bild entsteht.
Jede gerenderte Box wird mit etwa acht verschiedenen echten Greifern wiederverwendet, und jeder Ausschnitt landet bei jeder Ziehung auf einem neuen Zielrahmen. Synthetische Rahmen machen etwa ein Viertel jeder Trainingscharge aus.
Was wir auf die harte Tour gelernt haben
Das Rendern war der unkomplizierte Teil. Die meisten Erkenntnisse ergaben sich aus der Auswertung und der Installation:
Leiten Sie jede Klasse durch denselben Generator. Werden nur die zerlegten Kartons zusammengefügt, lernt das Modell, die Artefakte des Zusammenfügens zu erkennen, nicht den tatsächlichen Zustand der Kartons. Geschlossene Kartons und einfache Halterahmen durchlaufen exakt denselben Prozess, daher sagt die Tatsache, dass sie synthetisch sind, nichts über die Klasse aus.
Die meisten Überraschungen gab es in der Pipeline, nicht beim Rendering. Zeitweise schienen unsere Renderings auf der falschen Seite des Greifers zu liegen. Das Render-Rig funktionierte einwandfrei. Zwei Handgelenkkameras verwendeten denselben Dateinamen, und die Videoaufnahmen von links und rechts waren unbemerkt vermischt worden.
Wo es steht
Wir haben unseren Testdatensatz auf alle gekennzeichneten Versuche von zwei Produktionsstationen erweitert, etwa 12.000 Videos, und entfernte beide Stationen vollständig aus dem Training. Daraufhin wurde das Training mit gerenderten Kartons fortgesetzt. deutlich verbesserte Generalisierbarkeit vom Labor zur Produktion: Wir haben die FNR reduziert. 2.07mal bei FPR=1%. Die praktische Konsequenz: Wir können jetzt mit Produktionsmaterial trainieren, ohne darauf warten zu müssen, dass die Produktion genügend Boxen knackt.
Die nächste Generation von Renderings zielt auf die Fehler ab, die im Paket noch fehlen: zerrissene und deformierte Kartons, Wackeln und die dadurch verursachte Bewegungsunschärfe, Kartons, die an einer Lasche oder der Unterseite gehalten werden, und abwechslungsreichere Inhalte.
Was bedeutet das für physikalische KI, Simulation und reale Daten?
Sowohl in digitalen als auch in physischen Anwendungen ist es verlockend, synthetische Daten als vollständigen Ersatz für reale Erfahrungen zu betrachten. Der simulatororientierte Ansatz hat in der Robotik zu beeindruckenden Ergebnissen geführt. Fortbewegung, Rennen, und sogar Fußball. Es ist jedoch auf eine enge Rückkopplung zur realen Anwendung angewiesen, um den Simulator zu evaluieren und anzupassen.
Unsere Arbeit bei Nomagic verfolgt denselben Ansatz. In diesem Projekt gingen wir von realen Daten aus: Greifer, Hintergrund und Beleuchtung stammen aus der Produktion. Die Simulation dient als Datenmultiplikator, und wir erstellen künstliche Teile und Varianten, die die realen Daten um spezifische Informationen für Grenzfälle erweitern. Um die Datenerweiterung weiter voranzutreiben, müssen wir den Kreislauf erneut bis zum realen Einsatz schließen.
Diese Arbeit knüpft direkt an den von uns beschriebenen Mastery-First-Ansatz an. Ein bescheidener Kurswechsel für die physikalische KI Und Die letzten paar Prozent. Der Einsatz von Robotern und deren zuverlässige Autonomie hängen von der effizienten Lösung seltener und sporadischer Probleme ab, die nur im Produktionsbetrieb auftreten. Simulationen ersetzen nicht den eigentlichen Einsatzprozess, sondern beschleunigen ihn. Wenn wir auf neue Grenzfälle stoßen, müssen wir nicht warten, bis sie häufig genug auftreten, um daraus zu lernen; stattdessen lässt die Simulation unseren Datenstrom vervielfachen.
Wenn Sie auf die Entwicklung von KI-Systemen mit Fokus auf meisterhaftes Lernen setzen und die Auswirkungen von Simulationen auf die Implementierung beschleunigen möchten: Wir stellen ein! Link zu unserer Karriereseite
Von Michał Grzejdziak-Zdziarski, Senior Machine Learning Manager; Markus Wulfmeier, Chief Scientist: Sicherzustellen, dass jede an einen Kunden versandte Bestellung korrekt ist, klingt nach einem gelösten Problem – bis man genauer hinsieht…
Von Markus Wulfmeier, leitender Wissenschaftler. Auf der Suche nach einer universell einsetzbaren physikalischen KI richtet unser Fachgebiet seinen Blick stets nach vorn: Wir entwerfen massive Simulationen, analysieren Internetvideos und kuratieren immer größere Datensätze für die Teleoperation. Doch…
Von Filip Grządkowski, Vizepräsident für Ingenieurwesen: Im Wettlauf um die Automatisierung der physischen Welt ist Intelligenz nicht gleich Intelligenz. Jahrelang wurde die Robotik von Durchbrüchen in KI-Laboren vorangetrieben:…