Nie czekaj na awarię: mnożenie danych wdrożeniowych za pomocą symulacji
Autor: Szymon Trochimiak, starszy inżynier ds. badań ML
W przypadku fizycznej sztucznej inteligencji symulacja i świat rzeczywisty nie są konkurencyjnymi, lecz uzupełniającymi się źródłami danych. Czasami przedmiot otwiera się, gdy robot go niesie. Jeśli robot widzi rozmontowany przedmiot, może się zatrzymać i poprosić o pomoc. To właśnie jest zadaniem Live Anomaly Detection (w skrócie LAD). Najtrudniejsze jest ich poznanie, ponieważ robot rzadko napotyka anomalie (dlatego są anomaliami). Poniżej przedstawiamy, jak udało nam się wykorzystać dane syntetyczne do nauki LAD o awariach, które produkcja rzadko nam pokazuje.
Co robi LAD
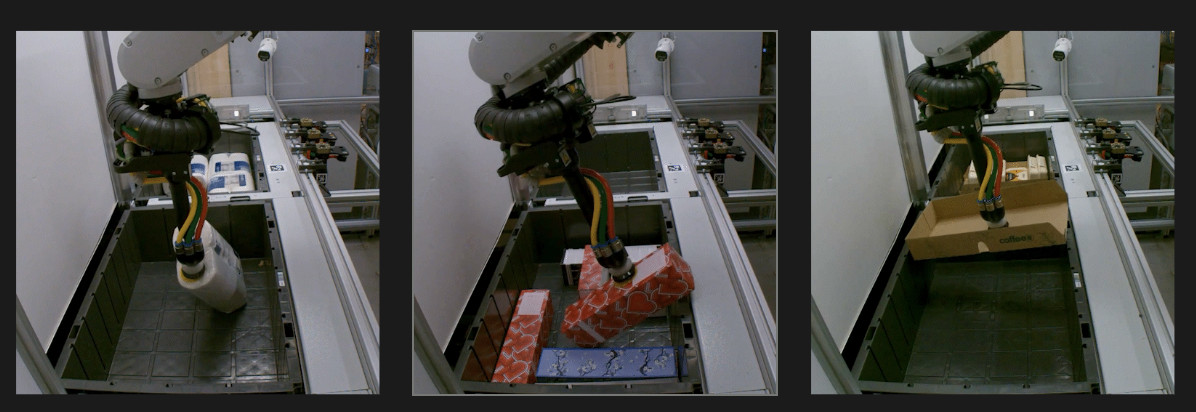
Live Anomaly Detection to system wizyjny, który śledzi obraz z kamery podczas każdego pobrania, z częstotliwością 15 klatek na sekundę. Dla każdej klatki system decyduje, czy napotkaliśmy anomalię, tj. rozmontowany przedmiot, czy nie. Jeśli dla danej próby model zwróci wynik pozytywny (tj. wykryto anomalię) dla trzech kolejnych klatek, robot zatrzymuje się, a zdalny operator sprawdza sytuację.
LAD ocenia się na podstawie dwóch liczb:
Wskaźnik wyników fałszywie ujemnych (FNR) to odsetek rozmontowanych pudełek, których nie wykrywamy;
Współczynnik wyników fałszywie dodatnich (FPR) to część dobrych wyborów, które błędnie zatrzymuje.
Pomyłka może spowodować, że w paczce klienta znajdzie się lek z brakującą zawartością. Fałszywy alarm kosztuje operatora uwagę i sekundy cyklu na stacji zbudowanej z myślą o setkach kompletacji na godzinę. Przy dużym natężeniu ruchu te sekundy się sumują, dlatego chcemy zminimalizować zarówno wskaźnik FPR, jak i FNR.
Dlaczego dane są trudną częścią
Roboty rejestrują każdy wybór, więc nagrań wideo jest pod dostatkiem. Użytecznych etykiet brakuje. Cztery rzeczy utrudniają ten problem:
Pozytywy zdarzają się rzadko. Około 1%. Nasz pierwszy zestaw testowy miał 37 pozytywnych prób na 2604 czyste. Przy tak małej liczbie pozytywnych wyników, jedno dodatkowe wykrycie zwiększa wskaźnik prawdziwie pozytywnych wyników o prawie trzy punkty. To utrudnia mierzenie postępów, a jeszcze trudniej wyciągać z nich wnioski.
Etykiety są drogie. Oznaczanie stanu pudełek klatka po klatce jest powolne. Większość filmów produkcyjnych nigdy nie jest oznaczana, a żaden z przypadków, których potrzebujemy najbardziej – pudełek na krawędzi otwarcia – nie jest łatwy do znalezienia.
Laboratorium nie wygląda na miejsce produkcji. Odtworzyliśmy w naszym laboratorium około 1600 prób demontażu na przygotowanych przedmiotach. Jednak komórki laboratoryjne wizualnie znacząco różnią się od produkcyjnych. Zatem dodanie danych laboratoryjnych nie wpłynęło wiarygodnie na poprawę wskaźników produkcji. Model nie uogólnił się między środowiskami.
Granice klasowe są subtelne. “Częściowo otwarty” i “całkowicie otwarty” różnią się o kilka stopni kąta klapy. Adnotatorzy nie są zgodni co do tego, gdzie dokładnie model najbardziej potrzebuje czystego sygnału.
Dlaczego renderujemy zamiast generować
Oczywistym “skrótem” byłby generatywny model obrazu, ale nie spełnia on dokładnie tych wymagań. Opisanie słowami, gdzie kończy się “częściowo otwarty”, a zaczyna “całkowicie otwarty”, nie jest wiarygodne. Trudno jest również wygenerować To samo pole o 20 i 25 stopniach otwarcia, co jest rodzajem kontrastowej pary, która uczy granicy. Etykieta odczytana z podpowiedzi to zgadywanie. Etykieta odczytana z geometrii jest dokładna.
Stworzyliśmy więc model parametrycznego opakowania farmaceutycznego w Blenderze. Każda właściwość istotna dla etykiety jest jawnie zdefiniowana:
Otwór od 0° (zamknięte) do 180° (całkowicie otwarte), plus boczne rozchylenie i podwinięcie klapki.
Wystająca zawartość – wyjmowanie blistrów i ulotek w granicach fizycznych możliwości otworu.
Zużycie powierzchni – falistości, szwów, zagnieceń i szorstkości.
Grafika i kolor, drgania kalibracji kamery i chwyt.
Jak przejść od specyfikacji do renderowanego i sklasyfikowanego pudełka:
Specyfikacja podaje rozkład dla każdego parametru.
Specyfikacja jest próbkowana w jednej scenie na pudełko.
Sceny renderowane są przy użyciu Blender Cycles na procesorach GPU.
Renderowanie jest dzielone na wznawialne fragmenty, po jednym na każdy GPU. Każde renderowanie trwa około 20 sekund.
Następnie klasa wynika z geometrii:
Powyżej 23,5° otwarcia pudełko uważa się za całkowicie otwarte (traktowane jako przedmiot rozmontowany);
Kąt między 2,5° a 23,5° uznaje się za częściowo otwarty (nie uznaje się go za rozmontowany).
Rys. 1: Wyrenderowane kartony w czterech stanach pudełka, tak jak widzi je kamera umieszczona na nadgarstku.
Jak render staje się ramką produkcyjną
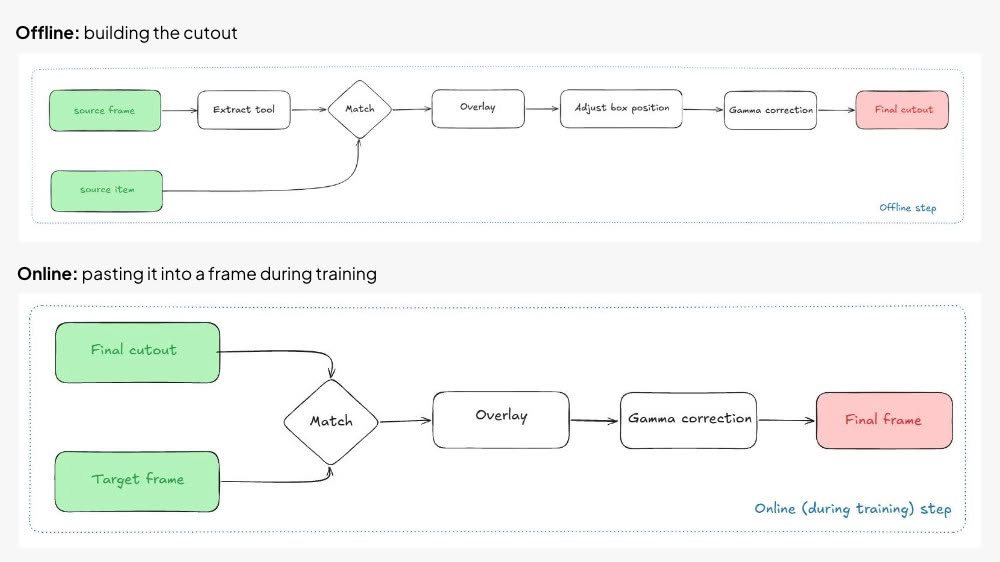
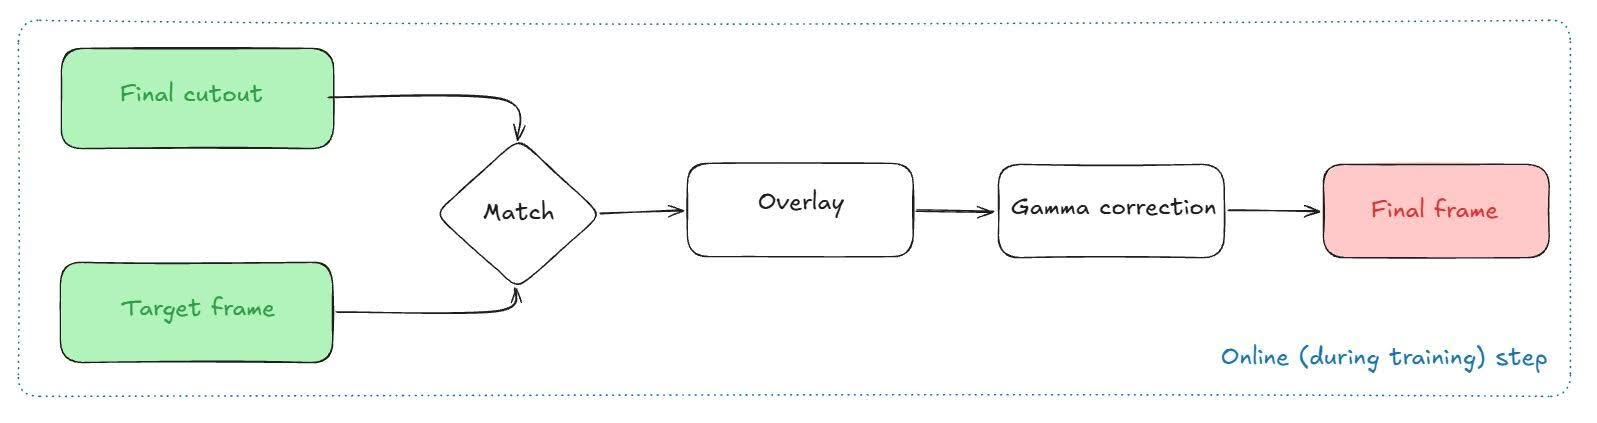
Wyrenderowany karton na szarym tle niewiele nauczy modelu o rzeczywistym środowisku produkcyjnym. Dlatego umieszczamy go w rzeczywistych ramkach, w dwóch etapach. Etap offline tworzy wycinek – prawdziwy chwytak trzymający wyrenderowany pojemnik – raz i go zapisuje. Etap online wkleja ten wycinek do rzeczywistej ramki za każdym razem, gdy jest rysowany podczas treningu, więc ten sam pojemnik pojawia się w wielu scenach.
Offline: budowanie wycięcia
Rys. 2: Krok offline, od ramki źródłowej i renderowanego elementu do zapisanego wycinka.
1. Ramka źródłowa. Prawdziwa rama, pochodząca z produkcji lub laboratorium, w której robot trzyma przedmiot. Ciśnienie ssania informuje nas, czy chwytak coś trzyma, dzięki czemu te ramy można podnosić automatycznie.
2. Wyjmij narzędzie. Nasz wewnętrzny model segmentacji znajduje chwytak i trzymany przedmiot. Zachowujemy chwytak i odrzucamy wszystko inne, w tym sam przedmiot. Zapisujemy również jasność przedmiotu i całej klatki do późniejszej korekty.
3. Element źródłowy. Wyrenderowany karton. Jego klasa jest ustalana przez geometrię renderu.
4. Dopasuj i nałóż. Łączymy chwytak z renderem wykonanym dla tej samej kamery i tego samego narzędzia, a następnie nakładamy prawdziwy chwytak na wyrenderowany karton. Jeśli chwytak nie nachodzi na pudełko, przesuwamy je, aż na nie najdzie.
5. Korekcja gamma. Rendery są jasne i ostre. Dopasowujemy jasność kartonu do jasności rzeczywistego przedmiotu, który zastępuje, i zapisujemy wynik jako ostateczny wycinek.
Online: wklejanie do ramki podczas treningu
Rys. 3: Krok online, uruchamiany podczas szkolenia, który wkleja zapisany wycinek do nowej ramki za każdym razem, gdy jest rysowany.
7. Ostateczne wycięcie i ramka docelowa. Trening ładuje wycięty fragment i rzeczywistą klatkę, w której robot niczego nie trzyma, pochodzącą od tego samego robota, kamery i narzędzia. Podobnie jak klatki źródłowe, można je pobrać za pomocą sygnału ssącego.
8. Nakładka i korekcja gamma. Wycięcie jest wklejane w jego własnym miejscu. Kamera na nadgarstku jest sztywno zamocowana do narzędzia, dzięki czemu wklejony chwytak pokrywa niemal cały uchwyt obiektu docelowego i nie jest wymagane doświetlanie. Na koniec dopasowujemy jasność całej klatki źródłowej do całej klatki docelowej, co daje klatkę używaną w treningu.
Każdy wyrenderowany blok jest ponownie wykorzystywany z około ośmioma różnymi, rzeczywistymi chwytakami, a każdy wycięty element trafia na nową ramkę docelową za każdym razem, gdy jest rysowany. Ramki syntetyczne stanowią około jedną czwartą każdej partii treningowej.
Czego nauczyliśmy się w trudny sposób
Wizualizacja była prostą częścią. Większość wniosków pochodziła z oceny i analizy:
Przypisz każdą klasę do tego samego generatora. Jeśli wklejane są tylko zdemontowane pudełka, model nauczy się wykrywać artefakty wklejania, a nie rzeczywisty stan pudełek. Zamknięte pudełka i proste ramki przechodzą przez dokładnie ten sam proces, więc bycie syntetycznym nic nie mówi o klasie.
Najwięcej niespodzianek dotyczyło rurociągów, a nie renderowania. W pewnym momencie nasze rendery wydawały się być po złej stronie chwytaka. Platforma renderująca działała prawidłowo. Dwie kamery nadgarstkowe miały tę samą nazwę pliku, a obraz z lewej i prawej strony był miksowany w trybie cichym.
Gdzie to stoi
Rozszerzyliśmy nasz zestaw testowy na wszystkie oznaczone próby z dwóch stanowisk produkcyjnych, około 12 000 filmów, i całkowicie wyłączyłem obie stacje z treningu. Na nim trening z renderowanymi kartonami znacznie ulepszona generalizacja z laboratorium do produkcji: zmniejszyliśmy FNR 2.07czasy przy FPR=1%. Praktyczna konsekwencja: możemy teraz trenować na materiale produkcyjnym, nie czekając, aż produkcja rozbije wystarczającą liczbę pudełek.
Nowa generacja renderów bierze na celownik wciąż brakujące wady: podarte i zdeformowane pudełka, chybotanie i wynikające z niego rozmycie obrazu, pudełka przytrzymywane klapką lub dolną ścianką oraz bardziej zróżnicowana zawartość.
Co to oznacza dla fizycznej sztucznej inteligencji, symulacji i danych ze świata rzeczywistego?
Zarówno w zastosowaniach cyfrowych, jak i fizycznych, kuszące jest traktowanie danych syntetycznych jako pełnego zamiennika doświadczenia w świecie rzeczywistym. Podejście oparte na symulatorze przyniosło imponujące rezultaty w dziedzinie robotów. lokomocja, wyścigi, i nawet piłka nożna. Opiera się jednak na ścisłym powiązaniu z rzeczywistym wdrożeniem w celu oceny i dostosowania symulatora.
Nasza praca w Nomagic podąża tą samą ścieżką. W tym projekcie zaczęliśmy od rzeczywistych danych: chwytak, tło i oświetlenie pochodzą z produkcji. Symulacja staje się mnożnikiem danych, a my renderujemy sztuczne części i warianty, rozszerzając rzeczywiste dane o informacje specyficzne dla przypadków brzegowych. Aby iterować proces rozszerzania, musimy ponownie zamknąć pętlę do wdrożenia w świecie rzeczywistym.
Praca ta bezpośrednio łączy się ze ścieżką „najpierw mistrzostwo”, którą opisaliśmy w Skromny zwrot w stronę fizycznej sztucznej inteligencji I Ostatnie kilka procent. Wdrożenie robotów i niezawodna autonomia zależą od efektywnego rozwiązywania rzadkich i sporadycznych problemów pojawiających się dopiero w produkcji. Symulacja nie zastępuje naszego koła zamachowego, ale je przyspiesza. Kiedy napotykamy nowe przypadki brzegowe, nie musimy czekać, aż będą się zdarzać wystarczająco często, aby się uczyć; zamiast tego pozwalamy symulacji zwielokrotnić nasz strumień danych.
Jeśli chcesz tworzyć zaawansowane fizyczne rozwiązania sztucznej inteligencji i przyspieszyć ich wpływ na symulację podczas wdrażania: szukamy Cię! Link do naszej strony poświęconej karierze
Autorzy: Michał Grzejdziak-Zdziarski, Starszy Menedżer ds. Uczenia Maszynowego; Markus Wulfmeier, Główny Naukowiec Upewnienie się, że każde zamówienie wysyłane do klienta jest prawidłowe, brzmi jak rozwiązany problem, dopóki się nie przyjrzysz…
Autor: Markus Wulfmeier, Główny Naukowiec W dążeniu do stworzenia uniwersalnej, fizycznej sztucznej inteligencji, nasza dziedzina wciąż patrzy w przyszłość: projektując ogromne symulacje, zbierając dane z internetu, gromadząc coraz większe zbiory danych teleoperacyjnych. A jednak…
Autor: Filip Grządkowski, Wiceprezes ds. Inżynierii W wyścigu o automatyzację świata fizycznego nie wszystkie inteligencje są sobie równe. Od lat motorem napędowym robotyki są przełomy w laboratoriach sztucznej inteligencji:…