No esperes al fracaso: Multiplicar los datos de despliegue mediante simulación
Por Szymon Trochimiak, ingeniero senior de investigación de ML
En la IA física, la simulación y el mundo real no son fuentes de datos competitivas, sino complementarias. A veces, un objeto se abre mientras el robot lo transporta. Si el robot detecta un objeto desmontado, puede detenerse y pedir ayuda. Esa es la función de la Detección de Anomalías en Tiempo Real (LAD, por sus siglas en inglés). La dificultad reside en aprender a identificarlas, ya que el robot rara vez se encuentra con anomalías (por eso se denominan anomalías). A continuación, se explica cómo logramos utilizar datos sintéticos para enseñar a LAD a detectar fallos que la producción rara vez nos muestra.
¿Qué hace LAD?
El sistema de detección de anomalías en tiempo real es un sistema de visión que monitoriza las imágenes de las cámaras durante cada recogida, a 15 fotogramas por segundo. En cada fotograma, determina si se ha detectado alguna anomalía, como un elemento desmontado. Si, en un intento determinado, el modelo detecta una anomalía durante tres fotogramas consecutivos, el robot se detiene y un operador remoto realiza una comprobación.
LAD se evalúa en función de dos cifras:
Tasa de falsos negativos (FNR) es la proporción de cajas desmontadas que no detectamos;
Tasa de falsos positivos (FPR) es la proporción de buenas selecciones que detiene erróneamente.
Un error puede provocar que un paquete de un cliente con medicamentos incompletos se envíe a su domicilio. Una falsa alarma supone una pérdida de tiempo y atención para el operario, especialmente en una estación diseñada para cientos de pedidos por hora. Con un alto volumen de pedidos, esos segundos se acumulan, por lo que buscamos minimizar tanto la tasa de falsos positivos como la de falsos negativos.
Por qué los datos son la parte difícil
Los robots graban cada selección, por lo que hay abundante material de vídeo. Sin embargo, no hay etiquetas útiles. Cuatro factores dificultan este problema:
Los resultados positivos son poco frecuentes. Prevalencia de aproximadamente 1%. Nuestro primer conjunto de prueba reservado tenía 37 intentos positivos frente a 2.604 limpios. Con tan pocos casos positivos, una detección adicional aumenta la tasa de verdaderos positivos en casi tres puntos. Esto dificulta la medición del progreso y, aún más, el aprendizaje a partir de él.
Las etiquetas son caras. Etiquetar el estado de las cajas fotograma a fotograma es lento. La mayoría de los vídeos de producción nunca se etiquetan, y ninguna de las cajas que más necesitamos (las que están a punto de abrirse) es fácil de encontrar.
El laboratorio no parece un entorno de producción. Recreamos aproximadamente 1600 procesos de desmontaje en nuestro laboratorio con piezas preparadas. Sin embargo, las celdas de laboratorio presentan diferencias visuales significativas con respecto a la producción. Por lo tanto, la incorporación de datos de laboratorio no mejoró de forma fiable las métricas de producción. El modelo no se generalizó entre diferentes entornos.
Las fronteras de clase son sutiles. “Las posiciones ”parcialmente abierta“ y ”totalmente abierta” difieren en unos pocos grados de ángulo de apertura. Los anotadores no coinciden en el punto exacto donde el modelo necesita una señal más nítida.
¿Por qué renderizamos en lugar de generar?
El “atajo” obvio sería un modelo de imagen generativo, pero falla precisamente en las cosas que necesitamos. Describir con palabras dónde termina “parcialmente abierto” y comienza “totalmente abierto” no es fiable. También es difícil generar el mismo Caja con una apertura de 20 y 25 grados, que es el tipo de par contrastivo que enseña un límite. Una etiqueta leída de una consigna es una suposición. Una etiqueta leída de geometría es exacta.
Así que modelamos una caja plegable farmacéutica paramétrica en Blender. Cada propiedad que importa para la etiqueta es un parámetro explícito:
Apertura desde 0° (cerrado) hasta 180° (totalmente abierto), además de apertura lateral y rizo de solapa plegada.
Protrusión del contenido – Los blísteres y folletos se pueden extraer, dentro de los límites que permite la abertura.
Desgaste superficial – ondulaciones, costuras, pliegues y asperezas.
Obras de arte y color, fluctuación en la calibración de la cámara y el comprender.
¿Cómo pasamos de una especificación a una caja renderizada y clasificada?
La especificación proporciona una distribución para cada parámetro.
La especificación se muestrea en una escena por caja.
Las escenas se renderizan con Blender Cycles en GPU.
El renderizado se divide en fragmentos reanudables, uno por GPU. Cada renderizado tarda unos 20 segundos.
La clase se deriva entonces de la geometría:
Si la apertura supera los 23,5°, la caja se considera completamente abierta (se considera un artículo desmontado);
Entre 2,5° y 23,5° se considera parcialmente abierto (no se considera desmontado).
Figura 1: Representación de las cajas en los cuatro estados de la caja, tal como las ve la cámara de muñeca.
Cómo un render se convierte en un fotograma de producción
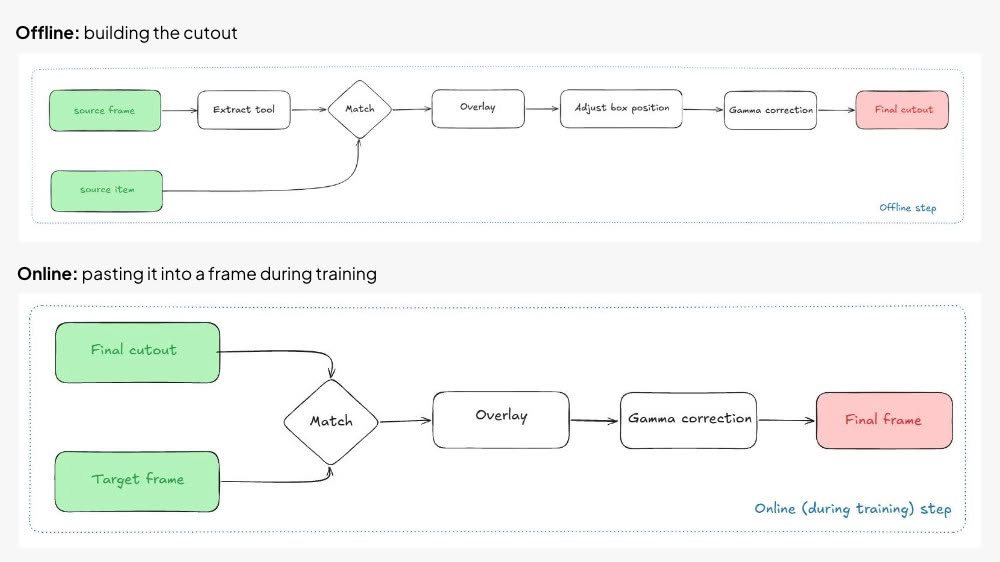
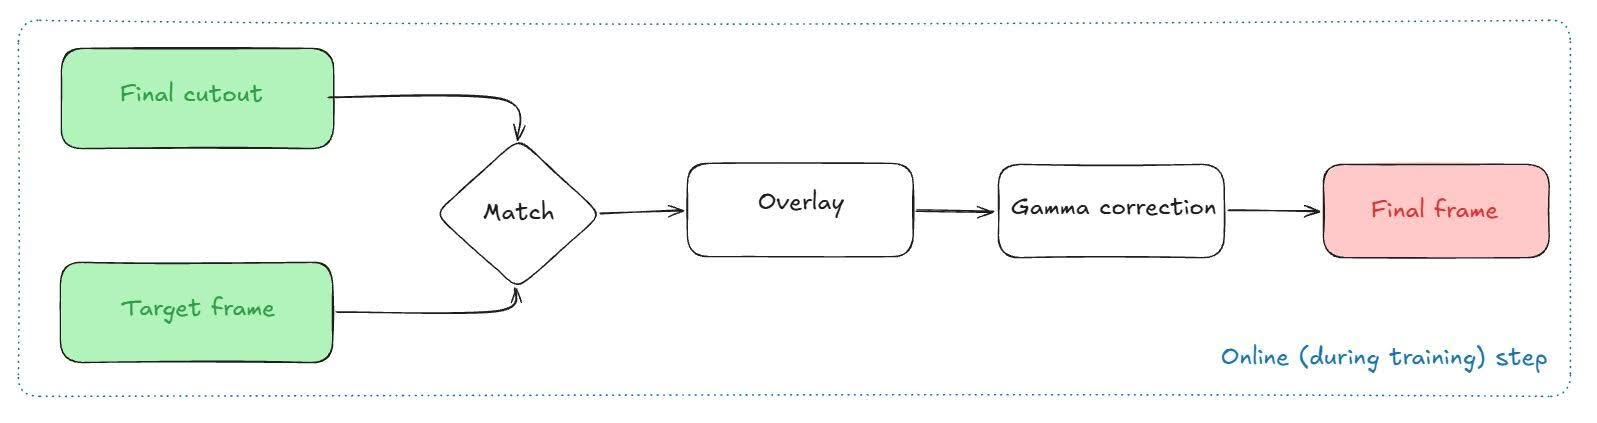
Una caja renderizada sobre un fondo gris no le enseñará mucho a un modelo sobre un entorno de producción real. Por eso, la integramos en fotogramas reales en dos etapas. La etapa offline crea una plantilla (una pinza real que sujeta la caja renderizada) una sola vez y la almacena. La etapa online inserta esa plantilla en un fotograma real cada vez que se realiza el entrenamiento, de modo que la misma caja aparece en muchas escenas.
Sin conexión: construyendo el recorte
Figura 2: El paso fuera de línea, desde un fotograma de origen y un elemento renderizado hasta un recorte almacenado.
1. Fotograma de origen. Un marco real, procedente de la producción o del laboratorio, en el que el robot sujeta un objeto. La presión de succión nos indica si la pinza sujeta algo, por lo que estos marcos se pueden recoger automáticamente.
2. Extrae la herramienta. Nuestro modelo de segmentación interno identifica la pinza y el objeto que se sujeta. Conservamos la pinza y descartamos todo lo demás, incluido el objeto real. También guardamos el brillo del objeto y de toda la imagen para realizar correcciones posteriormente.
3. Elemento fuente. Un cartón renderizado. Su clase viene determinada por la geometría del renderizado.
4. Emparejar y superponer. Combinamos la pinza con una imagen renderizada creada para la misma cámara y herramienta, y colocamos la pinza real sobre la caja renderizada. Si la pinza no se superpone a la caja, la desplazamos hasta que lo haga.
5. Corrección gamma. Las imágenes renderizadas resultan brillantes y nítidas. Ajustamos el brillo del cartón al del artículo real que reemplaza y almacenamos el resultado como el recorte final.
En línea: pegarlo en un marco durante el entrenamiento
Figura 3: El paso en línea, que se ejecuta durante el entrenamiento, pega un recorte almacenado en un nuevo fotograma cada vez que se dibuja.
7. Recorte final y marco objetivo. El entrenamiento carga una imagen recortada y una imagen real en la que el robot no sostiene nada, ambas tomadas con el mismo robot, cámara y herramienta. Al igual que las imágenes originales, estas se pueden seleccionar mediante la señal de succión.
8. Superposición y corrección gamma. El recorte se pega en su posición original. La cámara de muñeca está montada rígidamente en la herramienta, por lo que la pinza pegada cubre casi por completo la pinza del objetivo y no se necesita relleno. Finalmente, ajustamos el brillo de todo el fotograma de origen al de todo el fotograma de destino, lo que da como resultado el fotograma utilizado en el entrenamiento.
Cada caja renderizada se reutiliza con aproximadamente ocho pinzas reales diferentes, y cada recorte se coloca sobre un nuevo marco objetivo cada vez que se dibuja. Los marcos sintéticos representan aproximadamente una cuarta parte de cada lote de entrenamiento.
Lo que aprendimos por las malas
La representación gráfica fue la parte sencilla. La mayoría de las lecciones provinieron de la evaluación y la fontanería:
Dirige todas las clases a través del mismo generador. Si solo se pegan las cajas desmontadas, el modelo aprenderá a detectar los artefactos de pegado, no el estado real de las cajas. Las cajas cerradas y los marcos de soporte simples siguen exactamente el mismo proceso, por lo que el hecho de que sean sintéticas no dice nada sobre la clase.
La mayoría de las sorpresas fueron en el pipeline, no en el renderizado. En un momento dado, nuestras imágenes renderizadas parecían estar en el lado incorrecto de la pinza. El sistema de renderizado funcionaba correctamente. Dos cámaras de muñeca compartían el mismo nombre de archivo, y los vídeos izquierdo y derecho se habían mezclado silenciosamente.
En qué situación se encuentra
Ampliamos nuestro conjunto de pruebas a todos los intentos etiquetados de dos estaciones de producción, alrededor de 12.000 vídeos, y eliminó ambas estaciones del entrenamiento por completo. En él, entrenamiento con cartones renderizados Mejora significativa en la generalización del laboratorio a la producción: Redujimos la tasa de falsos negativos (FNR, por sus siglas en inglés). 2.07veces con FPR=1%. La consecuencia práctica: ahora podemos entrenar con material de producción sin esperar a que la producción rompa suficientes cajas.
La próxima generación de renderizados se centra en los fallos que aún faltan en el paquete: cajas rotas y deformadas, oscilaciones y el desenfoque de movimiento que provocan, cajas sujetas por una solapa o la cara inferior, y contenidos más variados.
¿Qué implicaciones tiene esto para la IA física, la simulación y los datos del mundo real?
Tanto en aplicaciones digitales como físicas, resulta tentador tratar los datos sintéticos como un sustituto completo de la experiencia del mundo real. El enfoque basado en simuladores ha dado lugar a resultados impresionantes en robótica. locomoción, carreras, e incluso fútbol. Pero depende de un ciclo estrecho de retroalimentación con la implementación en el mundo real para evaluar y adaptar el simulador.
Nuestro trabajo en Nomagic sigue el mismo camino. En este proyecto, partimos de datos reales: la pinza, el fondo y la iluminación provienen de la producción. La simulación se convierte en un multiplicador de datos y generamos piezas y variantes artificiales que amplían los datos reales con información específica para casos excepcionales. Para seguir mejorando los datos, necesitamos cerrar el ciclo y volver a la implementación en el mundo real.
Este trabajo se conecta directamente con el camino de dominio primero que describimos en Un humilde giro para la IA física y Los últimos pocos por ciento. El despliegue de robots y la autonomía confiable dependen de la resolución eficiente de problemas raros y esporádicos que solo aparecen en producción. La simulación no reemplaza nuestro ciclo de despliegue, pero lo acelera. Cuando nos encontramos con nuevos casos límite, no tenemos que esperar a que ocurran con la suficiente frecuencia para aprender; en cambio, dejamos que la simulación multiplique nuestro flujo de datos.
Si quieres crear IA física centrada en el dominio y acelerar el impacto de la simulación en la implementación: ¡Estamos contratando! Enlace a nuestra página de empleo
Por Michał Grzejdziak-Zdziarski, Gerente sénior de aprendizaje automático; Markus Wulfmeier, Científico jefe. Asegurarse de que cada pedido que se envía a un cliente sea correcto parece un problema resuelto hasta que se observa…
Por Markus Wulfmeier, Científico Jefe En nuestra búsqueda de una IA física de propósito general, nuestro campo sigue mirando hacia el horizonte: diseñando simulaciones masivas, recopilando vídeos de internet, organizando conjuntos de datos de teleoperación cada vez mayores. Sin embargo…
Por Filip Grządkowski, vicepresidente de ingeniería. En la carrera por automatizar el mundo físico, no toda la inteligencia es igual. Durante años, la robótica se ha visto impulsada por los avances en los laboratorios de IA:…