N’attendez pas l’échec : multiplier les données de déploiement par la simulation
Par Szymon Trochimiak, ingénieur de recherche senior en ML
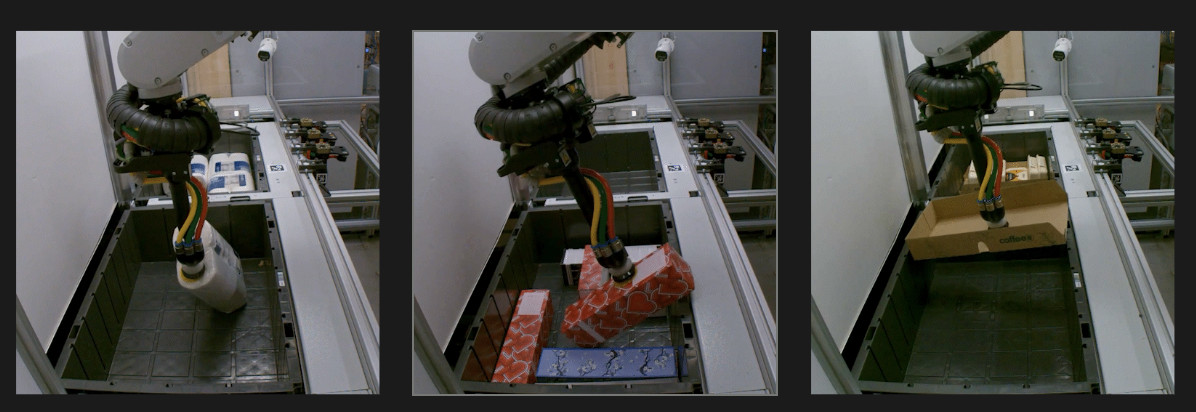
Pour l'IA physique, la simulation et le monde réel ne sont pas des sources de données concurrentes mais complémentaires. Il arrive qu'un objet s'ouvre pendant que le robot le transporte. Si le robot détecte un objet démonté, il peut s'arrêter et demander de l'aide. C'est le rôle de la détection d'anomalies en temps réel (LAD). La difficulté réside dans l'apprentissage de ces anomalies, car le robot les rencontre rarement (c'est d'ailleurs ce qui les définit). Nous expliquons ci-dessous comment nous avons utilisé des données synthétiques pour entraîner la LAD à reconnaître les défaillances que la production ne révèle que rarement.
Que fait LAD ?
Le système de détection d'anomalies en temps réel est un système de vision qui analyse les flux vidéo des caméras à 15 images par seconde pendant chaque prélèvement. Pour chaque image, il détermine si une anomalie a été détectée (par exemple, un élément démonté). Si, lors d'une tentative donnée, le modèle renvoie un résultat positif (anomalie détectée) pendant trois images consécutives, le robot s'arrête et un opérateur distant examine la situation.
LAD est évalué sur deux critères :
Taux de faux négatifs (FNR) représente la part des boîtes démontées que nous ne détectons pas ;
Taux de faux positifs (FPR) C'est la part des bons choix qu'il bloque à tort.
Une erreur peut entraîner l'envoi d'un médicament incomplet dans un colis client. Une fausse alerte mobilise l'opérateur et gaspille de précieuses secondes de cycle sur un poste conçu pour traiter des centaines de commandes par heure. À haut volume, ces secondes s'accumulent, il est donc essentiel de minimiser à la fois le taux de fausses alertes (FPR) et le taux de fausses alertes (FNR).
Pourquoi les données sont la partie difficile
Les robots enregistrent chaque prélèvement, les vidéos abondent donc. Les étiquettes utiles, en revanche, sont rares. Quatre facteurs rendent ce problème complexe :
Les cas positifs sont rares. Prévalence d'environ 1%. Notre premier ensemble de test mis de côté présentait 37 tentatives positives contre 2 604 tentatives réussies. Avec si peu de cas positifs, une détection supplémentaire fait augmenter le taux de positivité réel de près de trois points. Il est donc difficile de mesurer les progrès, et encore plus difficile d'en tirer des enseignements.
Les étiquettes coûtent cher. L'étiquetage image par image de l'état des boîtes est fastidieux. La plupart des vidéos de production ne sont jamais étiquetées, et les boîtes sur le point de s'ouvrir, dont nous avons le plus besoin, sont difficiles à trouver.
Le laboratoire ne ressemble pas à un site de production. Nous avons reproduit environ 1 600 séquences de démontage dans notre laboratoire sur des pièces préparées. Cependant, les cellules de laboratoire diffèrent sensiblement des cellules de production. Par conséquent, l'ajout de données de laboratoire n'a pas permis d'améliorer de manière fiable les indicateurs de production. Le modèle n'a pas pu être généralisé à d'autres environnements.
Les frontières de classe sont subtiles. “Les termes ” partiellement ouvert “ et ” complètement ouvert » ne diffèrent que de quelques degrés d'angle d'ouverture. Les annotateurs divergent quant à l'endroit précis où le modèle nécessite le plus un signal clair.
Pourquoi utilisons-nous le rendu au lieu de la génération ?
La solution de facilité évidente serait un modèle d'image génératif, mais il présente précisément les lacunes dont nous avons besoin. Décrire avec des mots où se termine “ partiellement ouvert ” et où commence “ totalement ouvert ” n'est pas fiable. Il est également difficile de générer… même Une boîte ouverte à 20 et 25 degrés, un exemple de paire contrastive permettant de visualiser une limite. Une étiquette lue à partir d'une consigne est une supposition. Une étiquette déduite de la géométrie est exacte.
Nous avons donc modélisé un étui pharmaceutique paramétrique pliant dans Blender. Chaque propriété importante pour l'étiquette est un paramètre explicite :
Ouverture de 0° (fermé) à 180° (complètement ouvert), plus éventement latéral et repli du rabat.
protrusion du contenu – les plaquettes thermoformées et les notices se soulèvent, dans les limites de l'ouverture.
Usure de surface – ondulations, coutures, plis et rugosité.
Œuvres d'art et couleurs, tremblement d'étalonnage de la caméra et le saisir.
Comment passe-t-on d'une spécification à une boîte rendue et classifiée ?
La spécification donne une distribution pour chaque paramètre.
Les spécifications sont échantillonnées dans une scène par boîte.
Les scènes sont rendues avec Blender Cycles sur GPU.
Le rendu est divisé en segments pouvant être repris, un par GPU. Chaque rendu prend environ 20 secondes.
La classe découle alors de la géométrie :
Au-delà de 23,5° d'ouverture, la boîte est considérée comme entièrement ouverte (comptée comme un article démonté) ;
Entre 2,5° et 23,5°, cela compte comme partiellement ouvert (ne compte pas comme démonté).
Fig. 1 : Cartons rendus dans les quatre états de boîte, tels que la caméra du poignet les voit.
Comment un rendu devient une image de production
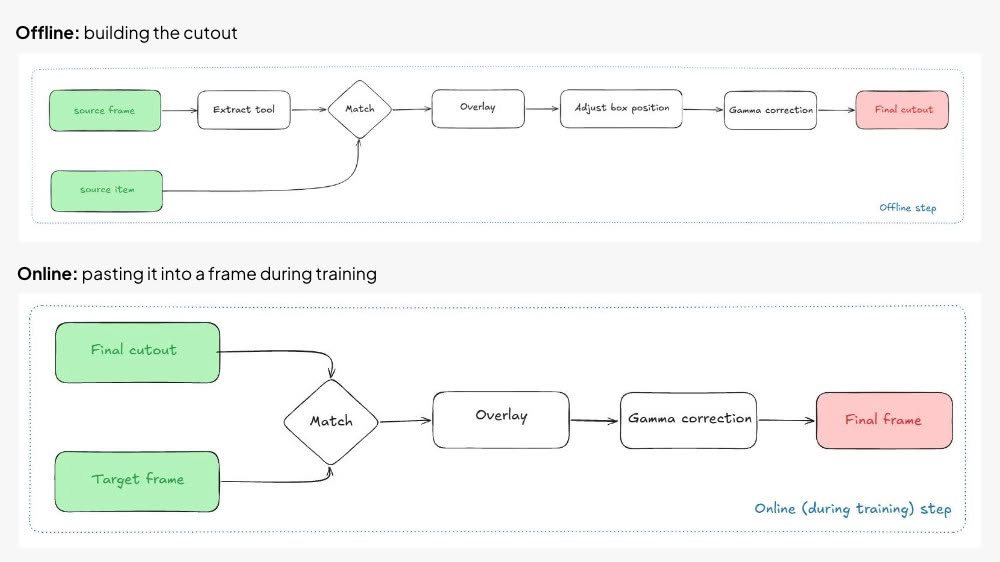
Un simple rendu de carton sur fond gris n'apprendra pas grand-chose à un modèle sur un environnement de production réel. Nous l'intégrons donc dans des images réelles, en deux étapes. La première étape, hors ligne, crée une découpe – une pince réelle maintenant une boîte modélisée – une seule fois, puis la sauvegarde. La seconde étape, en ligne, colle cette découpe dans une image réelle à chaque fois que le modèle d'entraînement la dessine, de sorte que la même boîte apparaisse dans de nombreuses scènes.
Hors ligne : construction de la découpe
Fig. 2 : L'étape hors ligne, d'une image source et d'un élément rendu à un découpage stocké.
1. Image source. Un cadre réel, issu de la production ou du laboratoire, dans lequel le robot maintient un objet. La pression d'aspiration indique si la pince saisit un objet, ce qui permet de prélever ces cadres automatiquement.
2. Extraire l'outil. Notre modèle de segmentation interne détecte la pince et l'objet tenu. Nous conservons la pince et éliminons tout le reste, y compris l'objet lui-même. Nous enregistrons également la luminosité de l'objet et de l'image entière pour des corrections ultérieures.
3. Élément source. Un carton rendu. Sa classe est définie par la géométrie du rendu.
4. Correspondance et superposition. Nous associons la pince à un rendu réalisé avec la même caméra et le même outil, puis nous superposons la pince réelle au carton rendu. Si la pince ne recouvre pas le carton, nous déplaçons ce dernier jusqu'à ce que ce soit le cas.
5. Correction gamma. Les rendus sont nets et précis. Nous ajustons la luminosité du carton à celle de l'objet réel qu'il remplace et enregistrons le résultat comme découpe finale.
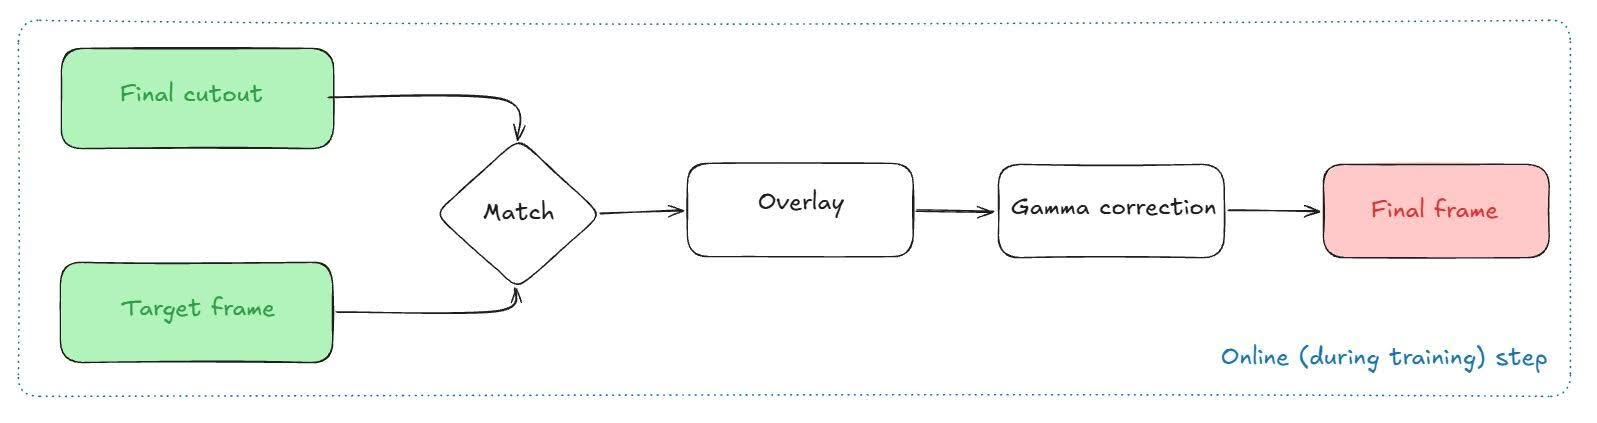
En ligne : l’insérer dans un cadre pendant la formation
Fig. 3 : L'étape en ligne, exécutée pendant l'entraînement, qui colle un découpage stocké sur une nouvelle image à chaque fois qu'il est dessiné.
7. Découpe finale et cadre cible. Le programme d'entraînement charge une image détourée et une image réelle où le robot ne tient rien, à partir des mêmes données du robot, de la même caméra et du même outil. Comme les images sources, elles peuvent être sélectionnées par un signal d'aspiration.
8. Superposition et correction gamma. Le découpage est collé à son emplacement. La caméra au poignet est fixée solidement à l'outil, de sorte que la pince collée recouvre presque entièrement la pince cible et qu'aucun remplissage n'est nécessaire. Enfin, nous harmonisons la luminosité de l'image source avec celle de l'image cible, ce qui donne l'image utilisée pour l'entraînement.
Chaque boîte rendue est réutilisée avec environ huit pinces réelles différentes, et chaque découpe se positionne sur une nouvelle image cible à chaque fois qu'elle est dessinée. Les images synthétiques représentent environ un quart de chaque lot d'entraînement.
Ce que nous avons appris à la dure
Le rendu était la partie la plus simple. La plupart des leçons provenaient de l'évaluation et de la plomberie :
Faites passer toutes les classes par le même générateur. Si seules les boîtes désassemblées sont collées, le modèle apprendra à détecter les artefacts de collage, et non l'état réel des boîtes. Les boîtes fermées et les cadres de maintien simples suivent exactement le même processus ; le fait qu'elles soient synthétiques ne nous renseigne donc pas sur leur nature.
La plupart des surprises concernaient le pipeline, et non le rendu. À un moment donné, nos rendus semblaient être du mauvais côté de la pince. Le système de rendu fonctionnait correctement. Deux caméras de poignet partageaient le même nom de fichier, et les flux vidéo gauche et droit avaient été mélangés sans avertissement.
Où cela se situe
Nous avons étendu notre ensemble de test à toutes les tentatives étiquetées provenant de deux stations de production, environ 12 000 vidéos, et a complètement supprimé les deux stations de formation. Sur celle-ci, la formation utilise des cartons rendus. Généralisation nettement améliorée du laboratoire à la production : nous avons réduit le FNR 2.07fois à FPR=1%. Conséquence pratique : nous pouvons désormais nous entraîner sur des images de production sans attendre que la production génère suffisamment de cassures.
La prochaine génération de rendus cible les défauts qui font encore défaut : boîtes déchirées et déformées, tremblements et flou de mouvement qu’ils provoquent, boîtes maintenues par un rabat ou la face inférieure, et contenus plus variés.
Quelles sont les implications pour l'IA physique, la simulation et les données du monde réel ?
Dans les applications numériques comme physiques, il est tentant de considérer les données synthétiques comme un substitut complet à l'expérience du monde réel. L'approche privilégiant la simulation a permis d'obtenir des résultats impressionnants en robotique. locomotion, courses, et même football. Mais il nécessite un retour rapide au déploiement dans le monde réel pour évaluer et adapter le simulateur.
Notre travail chez Nomagic suit la même approche. Dans ce projet, nous sommes partis de données réelles : la pince, l’arrière-plan et l’éclairage proviennent de la production. La simulation devient un multiplicateur de données et nous créons des pièces et des variantes artificielles, enrichissant les données réelles d’informations spécifiques à chaque cas particulier. Pour itérer sur l’augmentation, nous devons à nouveau boucler la boucle jusqu’au déploiement en situation réelle.
Ce travail s'inscrit directement dans la voie de la maîtrise d'abord que nous avons décrite dans Un pivot humble vers l'IA physique et Les derniers pour cent. Le déploiement de robots et leur autonomie fiable reposent sur la résolution efficace des problèmes rares et sporadiques qui n'apparaissent qu'en production. La simulation ne remplace pas notre processus de déploiement, mais l'accélère. Face à de nouveaux cas limites, nous n'avons plus besoin d'attendre qu'ils se produisent suffisamment souvent pour en tirer des enseignements ; la simulation multiplie notre flux de données.
Si vous souhaitez développer une IA physique axée sur la maîtrise et accélérer l'impact de la simulation sur le déploiement : nous recrutons ! Lien vers notre page carrières
Par Michał Grzejdziak-Zdziarski, responsable principal de l'apprentissage automatique ; Markus Wulfmeier, scientifique en chef. S'assurer que chaque commande expédiée à un client est correcte semble être un problème résolu jusqu'à ce qu'on y regarde de plus près…
Par Markus Wulfmeier, directeur scientifique. Dans notre quête d'une IA physique à usage général, notre domaine reste tourné vers l'avenir : conception de simulations massives, collecte de données vidéo sur Internet, constitution d'ensembles de données de téléopération toujours plus vastes. Pourtant…
Par Filip Grządkowski, vice-président de l'ingénierie. Dans la course à l'automatisation du monde physique, toutes les formes d'intelligence ne se valent pas. Pendant des années, la robotique a été portée par les percées réalisées dans les laboratoires d'IA :…
Contactez Nomagic pour découvrir comment notre technologie innovante peut faire passer vos processus de traitement des commandes à la vitesse supérieure.